yuangang.me
yuangang.me
Home
Publications
Experience
Services
Contact
CV
Benchmarking
NeurIPS 2026 E&D
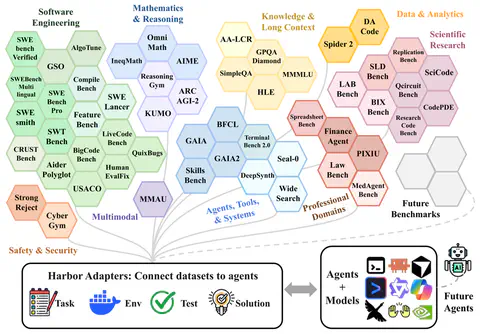
Harbor Adapters and Harbor-Index: Infrastructure and a Curated Meta-Dataset for Large-Scale Agentic Evaluation
Lin Shi
,
Haowei Lin
,
Zixuan Zhu
,
Xiaoyue Zhou
,
Xiang Li
,
Xiangning Lin
,
Yaxuan Deng
,
Han Xu
,
Yuangang Li
,
et al. (140+ authors)
PDF
Code
Dataset
Project
DOI
NeurIPS 2026 E&D
Agents' Last Exam
Yuangang Li
with Team
PDF
EMNLP 2026
Beyond Output Correctness: Benchmarking and Evaluating Large Language Model Reasoning in Coding Tasks
Yuangang Li
,
Justin Tian Jin Chen
,
Ethan Yu
,
David Hong
,
Iftekhar Ahmed
PDF
DOI
EMNLP 2025 Findings
NLP-ADBench: NLP Anomaly Detection Benchmark
Yuangang Li
,
Jiaqi Li
,
Zhuo Xiao
,
Tiankai Yang
,
Yi Nian
,
Xiyang Hu
,
Yue Zhao
PDF
Code
DOI
ACL 2025 Findings
AD-LLM: Benchmarking Large Language Models for Anomaly Detection
Tiankai Yang
,
Yi Nian
,
Li Li
,
Ruiyao Xu
,
Yuangang Li
,
Jiaqi Li
,
Zhuo Xiao
,
Xiyang Hu
,
Ryan A. Rossi
,
Kaize Ding
,
Xia Hu
,
Yue Zhao
PDF
DOI
Cite
×